“Agent harness” é um daqueles termos que parecem vagos até percebermos o problema que tentam resolver.
Nos últimos meses, “harness” passou a aparecer em quase todas as conversas sobre agentes de IA. A explicação mais comum é que o harness é “o ambiente do agente”. Está correta, mas não ajuda muito a perceber o que é, o que não é, e em que difere de prompt engineering ou context engineering.
Este artigo parte de um vídeo do canal Caleb Writes Code — “Agent Harness explained in 8min” — e organiza as ideias principais com a minha leitura sobre o que isto significa para quem constrói produtos.
A tese central é simples:
Harness engineering não substitui prompt engineering nem context engineering. Usa as duas — dentro de um ambiente com regras claras sobre como o agente começa, executa, verifica e termina cada tarefa.
Da prompt ao contexto: como chegámos aqui
Pouco depois do lançamento do ChatGPT, em 2022, trabalhávamos com janelas de contexto de cerca de 4.000 tokens. Era pouco espaço para qualquer coisa substancial.
Era possível construir agentes à volta disso, mas rapidamente ficou claro que escrever uma boa prompt não chegava. A pergunta passou a ser outra:
Como reaproveitar um espaço de memória pequeno para fazer mais com menos?
Foi assim que passámos de prompt engineering para context engineering, com técnicas como:
- Tool calling — o agente explora o repositório, lê apenas os ficheiros relevantes para a tarefa e executa ações externas;
- MCP (Model Context Protocol) — permite acrescentar capacidades de fornecedores específicos por cima do modelo;
- RAG — liga bases de dados próprias para que a informação certa esteja disponível quando é precisa.
Estas técnicas deram origem a uma nova geração de agentes, sobretudo de programação. Ferramentas como Cursor, Windsurf, Cline, Roo Code e Aider adotaram tool calling para gerir o contexto — e eram (e são) boas ferramentas.
Ao mesmo tempo, os modelos evoluíram e as janelas de contexto cresceram. Os agentes passaram a conseguir trabalhar em tarefas mais longas, e as pessoas começaram a pedir-lhes funcionalidades e correções com um âmbito cada vez maior.
O limite: tarefas longas e resumos que perdem informação
Mesmo com bom context engineering, havia um teto.
Peça a um agente algo enorme — por exemplo, “clona este website inteiro”. Com uma prompt simples, o resultado é um site frágil, porque o modelo responde de uma só vez. Com context engineering, o resultado melhora, mas continua longe do ideal: o site fica parcialmente terminado, há botões que não funcionam e funcionalidades que nunca foram testadas de ponta a ponta.
O problema não era o context engineering em si. Era um mecanismo em particular: o resumo contínuo do contexto.
Imagine uma tarefa que demora 12 horas. À medida que a janela de contexto enche, o agente resume o que já fez para libertar espaço e continua. E volta a resumir. E outra vez.
Na prática, o agente fica limitado pela qualidade dos seus próprios resumos. É por isso que surgem tarefas:
- meio feitas;
- nem sequer tentadas;
- dadas como concluídas quando não estavam;
- simplificadas ao ponto de funcionalidades serem marcadas como “verificadas” sem nunca terem sido testadas.
Esta forma elástica de gerir o contexto dava a aparência de conseguir trabalhar em tarefas longas. Mas não era tão eficaz quanto parecia.
A convergência: subagentes, swarms e orquestração
Antes de o termo existir, já havia várias tentativas de contornar o problema:
- subagentes, para uma gestão hierárquica do contexto;
- swarms de agentes, em que vários agentes trabalham em paralelo, cada um com a sua própria janela de contexto.
Todas estas abordagens apontavam na mesma direção. Os ingredientes necessários eram:
- uma melhor camada de orquestração;
- um melhor ambiente de execução;
- uma melhor gestão de contexto.
É esta combinação que passou a ser chamada agent harness, termo que se popularizou no início de 2026. Pode ser visto como um buzzword — mas descreve uma mudança real na forma como a indústria está a construir agentes.
A grande mudança: loops com contexto limpo
A alteração mais importante trazida pelo harness engineering é a ideia de loop.
Em vez de manter um agente a trabalhar numa sessão que vai acumulando e resumindo contexto, subimos uma camada acima do context engineering:
- o agente trabalha em iterações;
- em cada iteração recebe uma prompt e um contexto novos e limpos;
- existe uma regra estrita sobre como cada iteração começa e como termina.
Um fluxo típico funciona assim:
- Gera-se um documento de requisitos extenso (por exemplo, um PRD — product requirements document);
- Esse documento é convertido numa lista estruturada de tarefas, muitas vezes em JSON;
- Em cada iteração, o agente seleciona apenas uma tarefa;
- Implementa-a;
- Testa-a;
- Documenta o que fez e atualiza o progresso;
- A iteração termina — e a seguinte começa com contexto limpo, lendo o estado a partir dos ficheiros, e não de um resumo na memória.
O loop repete-se até todas as tarefas estarem concluídas.
Um dos exemplos que mais se popularizou foi o Ralph (a técnica “Ralph Wiggum loop”, descrita por Geoffrey Huntley). O que chamou a atenção não foi apenas a eficácia, mas a simplicidade da arquitetura: o repositório é pequeno.
A Anthropic publicou uma demonstração com a mesma lógica — um ambiente leve, com um agente inicializador que prepara os requisitos e o registo de progresso, e um agente que avança funcionalidade a funcionalidade, deixando o trabalho num estado limpo no fim de cada sessão.
Muitos agentes de programação já incorporam esta camada de harness diretamente na aplicação — cada um à sua maneira.
Prompt, contexto e harness: camadas, não substitutos
Uma clarificação importante do vídeo: harness engineering não torna obsoleto o context engineering, e muito menos o prompt engineering.
Se olharmos para o system prompt de agentes open-source como o Cline, continua a ser, em grande parte, uma prompt bem escrita. A diferença é o peso relativo:
- Prompt engineering — diz ao agente quem ele é e dá-lhe a persona e as regras base. Continua presente, mas é uma componente mais pequena do sistema;
- Context engineering — decide o que o agente vê em cada momento: ficheiros, ferramentas, dados;
- Harness engineering — define o ambiente e a sequência de passos em que o agente trabalha: como começa, que tarefa escolhe, como verifica e quando termina.
O harness usa as outras duas camadas. A mudança de paradigma está no ambiente, não no abandono das técnicas anteriores.
A anatomia de um harness
Uma forma útil de pensar nisto é:
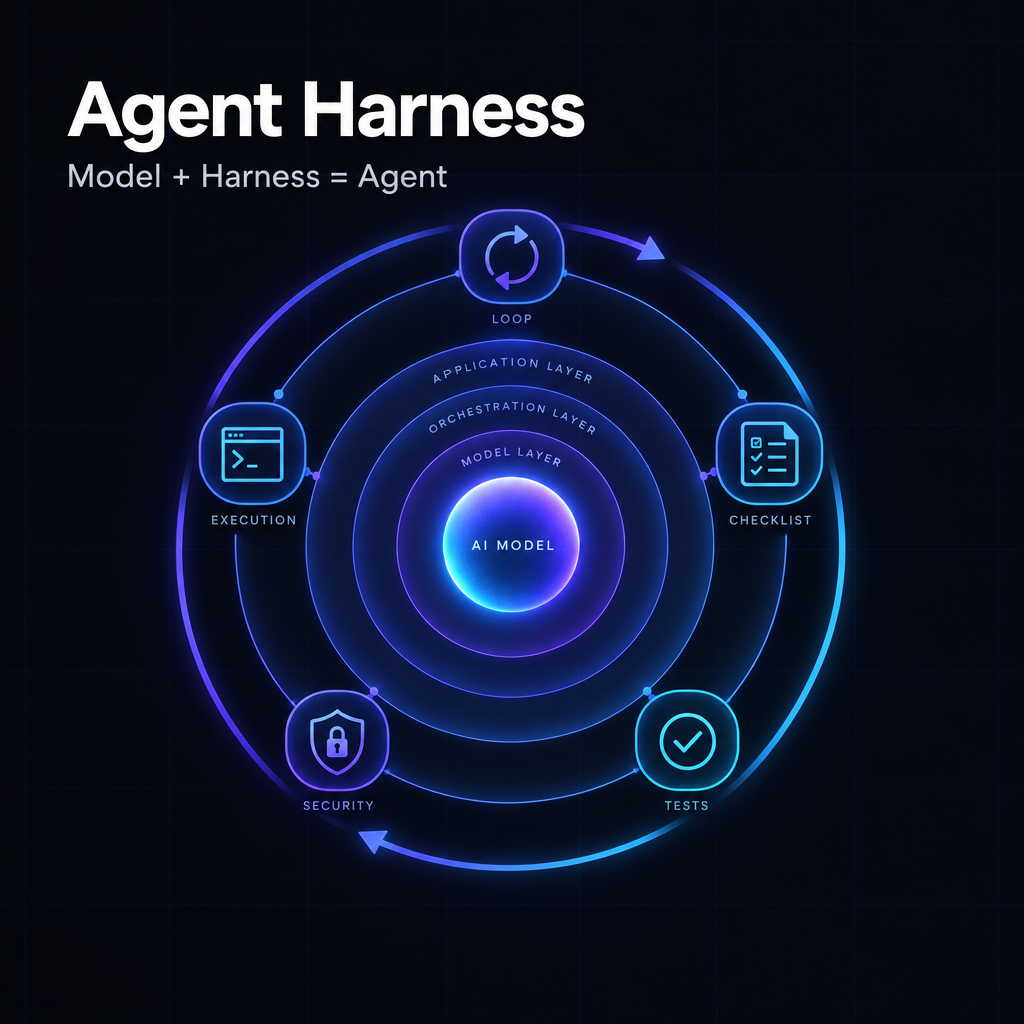
Agente = modelo + harness.
Tudo o que não é o modelo faz parte do harness. Na prática, isso inclui:
- loop de execução — o ciclo que decide quando uma iteração começa e acaba;
- ferramentas — tool calling e MCP;
- gestão de contexto — o que entra em cada iteração;
- estado persistente — ficheiros de progresso, histórico no git;
- ambiente de execução — normalmente uma sandbox;
- permissões e aprovações — o que o agente pode fazer sozinho e o que exige validação humana;
- verificação — testes, linters, verificações automáticas;
- orquestração — subagentes e coordenação entre eles.
Nenhum destes componentes é novo isoladamente. O que é novo é tratá-los como um sistema desenhado de propósito.
O que isto significa para quem constrói produtos
Há uma consequência deste modelo que me parece pouco discutida.
Se o loop começa num documento de requisitos e executa uma tarefa de cada vez, então a qualidade do resultado depende da qualidade desses requisitos. Um agente com um excelente harness vai implementar, testar e documentar — com disciplina — exatamente aquilo que lhe foi pedido.
Se o que foi pedido não resolve um problema real, o harness só torna mais eficiente a construção da coisa errada.
É aqui que vejo a ligação com o trabalho que fazemos na Painstack:
- Sinais de mercado — o que as pessoas dizem, procuram e já tentam resolver;
- Evidência organizada — confrontar hipóteses com dados em vez de intuição;
- Problema validado — decidir o que vale a pena construir;
- Requisitos (PRD) — só depois disto escrever o documento que alimenta o loop;
- Loop do harness — o agente implementa tarefa a tarefa;
- Testes — por exemplo com Playwright, para verificar os percursos principais;
- Produto em produção.
A Painstack não é um harness nem substitui a engenharia. O seu papel está antes do loop: ajudar a garantir que o documento de requisitos parte de um problema com evidência.
Validar o que construir antes de automatizar a construção.
Conclusão
A evolução foi mais ou menos esta:
- Prompt engineering: pedir bem;
- Context engineering: mostrar ao modelo a informação certa;
- Harness engineering: desenhar o ambiente, as regras e o ciclo em que o agente trabalha.
A lição mais prática é a dos loops: em tarefas longas, contexto limpo em cada iteração e estado guardado em ficheiros tendem a funcionar melhor do que uma única sessão que se resume a si própria até perder detalhes.
Mas um harness não decide o que vale a pena construir. Isso continua a ser trabalho nosso.
Referências
- Caleb Writes Code — “Agent Harness explained in 8min”
- Anthropic — Effective harnesses for long-running agents
- Geoffrey Huntley — Ralph Wiggum as a “software engineer”
- Model Context Protocol
- Painstack
Nota: o vídeo inclui um segmento patrocinado pela Cursor, que não foi usado como fonte deste artigo.